카파시와 함께 배우는 LLM Part 2
배경
- AI 스터디 6기 활동의 일환
- 카파시의 이 영상을 나눠서 보고 있습니다. 이번 주는 31분에서 59분까지 봤습니다.
- 온라인으로 모여 1시간 ~ 1시간 반 정도 이야기를 나눕니다.
- 소재는 영상과 각자 영상을 보고 남긴 코멘트입니다.
- 스터디를 하며 일주일마다 느끼는 점을 공개 기록으로 남기고 싶었습니다.
영상 내용 요약
- 카파시는 GPT-2(2019, OpenAI)로 학습 과정을 보여 줍니다. 매개변수 약 15억 개, 한 번에 볼 수 있는 토큰 1,024개로 지금 기준으로는 작지만, 요즘 모델과 같은 구성이 처음 갖춰진 모델입니다. 2019년에 약 4만 달러가 들던 학습을 카파시가 다시 해 보니 하루, 약 600달러였습니다.
- 학습 중에는 손실(loss) 하나를 지켜봅니다. 손실이 내려갈수록 무작위이던 출력이 조금씩 말이 됩니다.
- 이 계산은 GPU로 합니다. 신경망을 학습할 때 하는 행렬 곱은 수많은 일꾼이 동시에 나눠 풀 수 있는 계산이라 GPU에 딱 맞습니다. 빅테크가 GPU를 앞다퉈 모으는 이유입니다.
- 학습이 끝나면 기본 모델(base model)이 나옵니다. 질문에 답하는 비서가 아니라 인터넷 글을 이어 쓰는 "아주 비싼 자동 완성"입니다. 자주 본 글은 외워서 그대로 말하고, 본 적 없는 일은 그럴듯하게 지어냅니다(환각).
- 그래도 프롬프트를 잘 짜면 쓸 만합니다. 영어와 한국어 낱말 10쌍 뒤에 teacher를 두면 "선생님"(진짜 한국어로 말했습니다. 발음도 좋았어요!!)을 내놓고(문맥 안 학습, in-context learning), 대화처럼 생긴 글을 주면 비서처럼 답합니다.
행렬 곱과 내적
- 영상에서 카파시는 행렬 곱 연산 자체를 병렬로 할 수 있고, 그래서 병렬 연산에 강한 GPU가 각광받는다고 했는데요. 처음에는 행렬 곱을 병렬로 한다는 건지, 아니면 행렬 곱 자체를 병렬로 수행할 수 있다는 건지 헷갈렸습니다. 일단 이 질문의 답은 후자였고요.
- 처음에는 행렬 곱과 내적(dot product)이 같은 걸 말하는 줄 알았습니다. 하지만 아니었습니다..
- 내적은 길이가 같은 두 벡터(숫자 목록)에서 같은 자리의 숫자끼리 곱해 모두 더한 값 하나입니다. 두 벡터가 얼마나 같은 쪽을 가리키는지를 잽니다. 비슷한 쪽이면 양수, 직각이면 0, 반대쪽이면 음수가 나옵니다.[1]
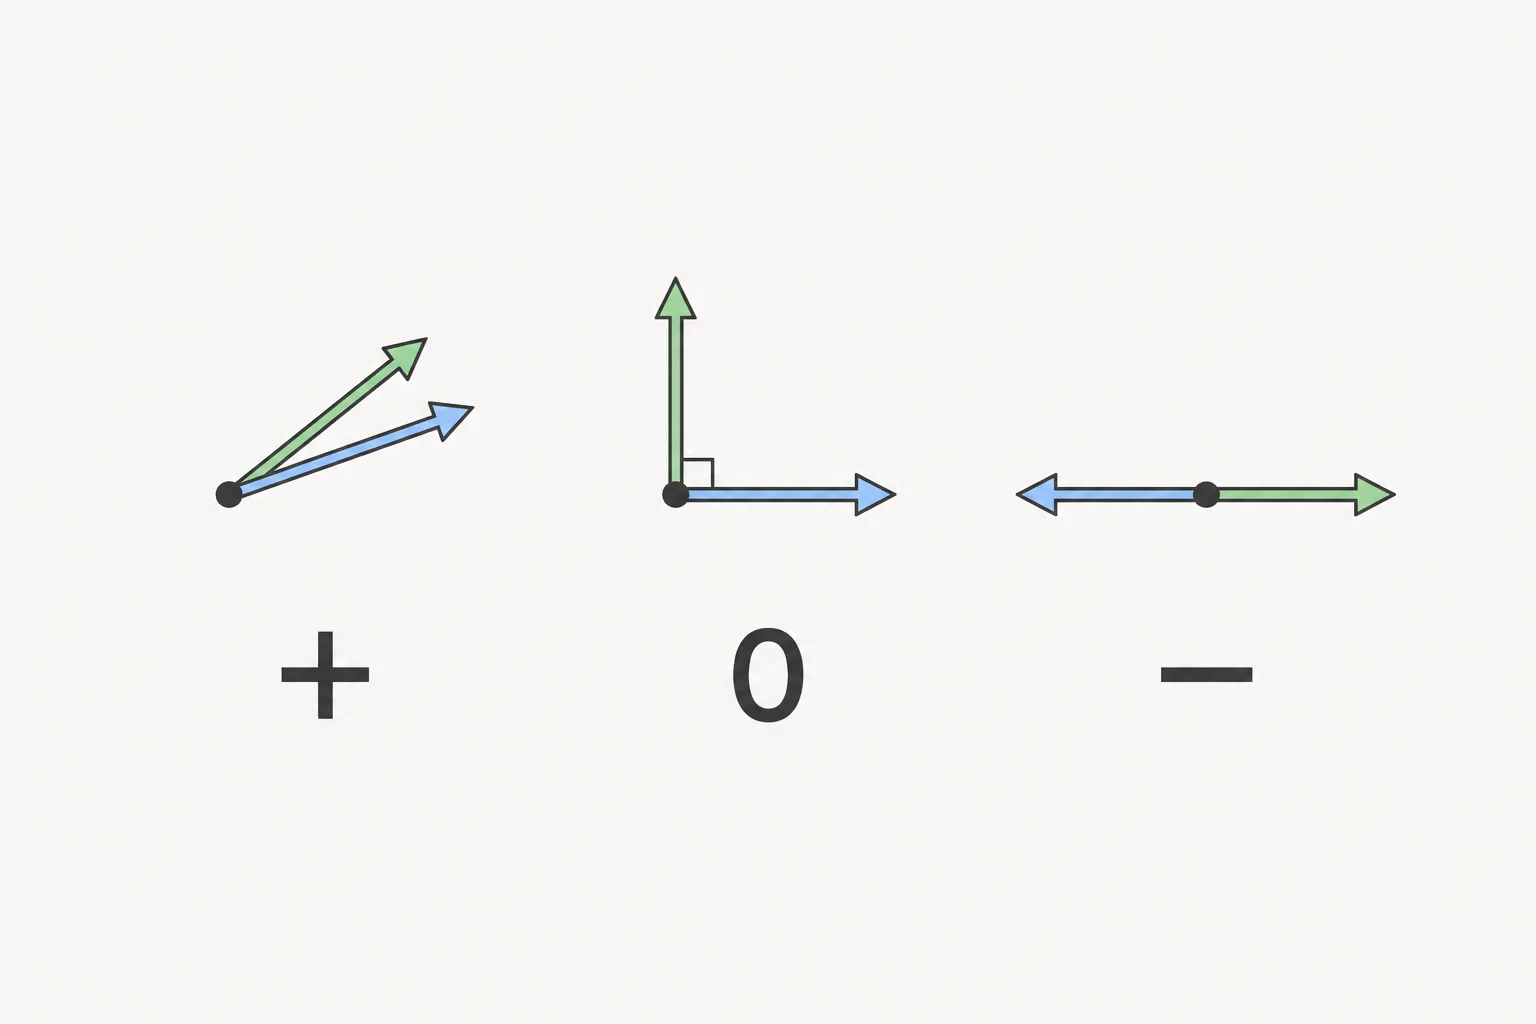
화살표 방향에 따라 달라지는 내적의 부호
- 행렬 곱은 이 내적을 결과의 칸마다 한 번씩 하는 계산입니다. 결과의 i행 j열 칸은 앞 행렬의 i번째 행과 뒤 행렬의 j번째 열의 내적입니다.[2] 예를 들어 행 [1, 2]와 열 [3, 4]가 만나는 칸은 1×3 + 2×4 = 11입니다.
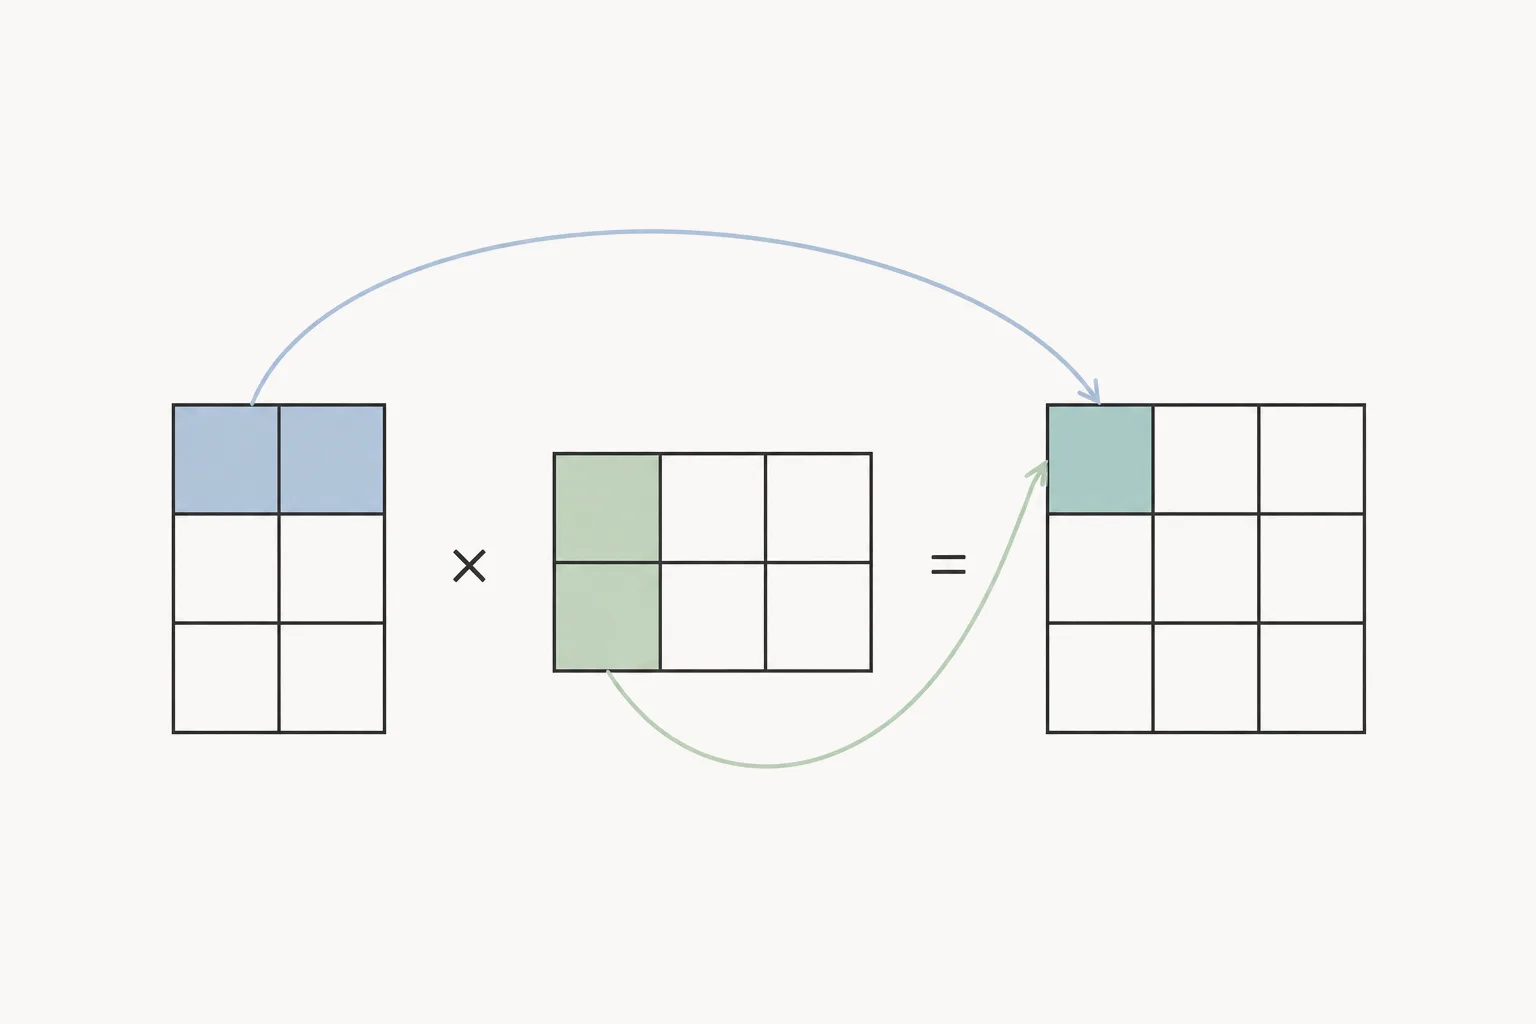
한 행과 한 열이 만나 생기는 결과의 한 칸
- 신경망의 많은 계산이 이 행렬 곱입니다. 층의 뉴런 하나는 입력과 그 뉴런의 가중치를 내적하고, 뉴런 여러 개와 토큰 여러 개를 한꺼번에 계산하면 행렬 곱이 됩니다.[3] 트랜스포머의 어텐션도 토큰마다 만든 query(무엇을 찾는지)와 key(나는 무엇인지)의 내적으로 어느 토큰을 얼마나 볼지 정합니다.[4]
- 병렬에 맞는 이유는 칸끼리 서로 기다리지 않아서입니다. 옆 칸을 계산할 때 앞 칸의 답이 필요 없으니 칸마다 다른 일꾼에게 맡겨 동시에 계산할 수 있습니다. GPU도 결과 행렬을 조각으로 나눠 수많은 계산 묶음에 맡깁니다. 다만 칸 하나 안에서는 곱한 값을 모아 더해야 답이 나오므로, 그 덧셈은 기본적으로 차례대로 쌓아 갑니다.[5]
GPT-2 가중치는 깃허브에서 바로 볼 수 있나?
- 카파시는 모델을 공개하려면 두 가지가 필요하다고 했습니다. 계산 순서를 적은 코드, 그리고 학습으로 정해진 매개변수(가중치)입니다.
- 모임에서 제가 질문했습니다. 깃허브에 공개된 GPT-2가 이미 학습된 버전이냐고요. 저는 가중치가 정해진 상태로 올라가 있는 줄 알았습니다. 한 분이 모델은 너무 무거워서 깃허브에 못 올라갈 테니 코드만 있을 거라고 답해 주셨습니다.
- 모임이 끝나고 확인해 보니 둘 다 반만 맞았습니다. 깃허브 저장소에는 코드만 있습니다. 대신 저장소의
download_model.py가 OpenAI의 다른 저장 공간에서 가중치를 포함한 파일 7개를 받아 옵니다. 가장 큰 모델(1558M)의 가중치 파일은 6,230,444,800 바이트, 약 6.2GB입니다.[6] - 깃허브는 100MiB가 넘는 파일을 막습니다.[7] 6.2GB짜리 가중치는 저장소에 그대로 넣을 수 없는 크기입니다.
결론(+ 좋았던 점)
저는 스터디에서 항상 마지막에 모두가 소감을 말하도록 부탁합니다. 마무리하는 느낌도 들고, 피드백도 직간접적으로 들을 수 있기 때문이에요.
- 소감 공유 시간에, 다들 모임에서 다양한 사람들의 다양한 의견을 들을 수 있다고 해주셔서 스터디가 그 역할을 다 하고 있구나, 해서 뿌듯하고 보람 있었습니다.
- 디스코드 채널에서는 모임에서 나눈 이야기의 후속 메시지가 이어졌습니다. 6기에서는 이런 적이 처음이고 구성원분들의 참여와 따뜻한 마음씨가 느껴져서 기분이 좋았습니다.
관련 글
- 어려운 영상 쉽게 이해하고 싶을 때 내가 사용한 방법 | Deep Dive into LLMs like ChatGPT (1/6) 생각 정리 - 같은 카파시 영상의 앞부분을 이해해 간 과정
- The spelled-out intro to neural networks and backpropagation: building micrograd 후기 - 신경망과 역전파의 기초를 직접 배우는 과정
- 스터디, 어떻게 하면 잘 운영할 수 있을까? - 다양한 의견과 참여를 이끄는 스터디 운영 방법
Wikipedia, "Dot product." https://en.wikipedia.org/wiki/Dot_product (accessed 2026-11-14) ↩︎
Wikipedia, "Matrix multiplication." https://en.wikipedia.org/wiki/Matrix_multiplication (accessed 2026-11-14) ↩︎
NVIDIA, "Matrix Multiplication Background User's Guide," 1장. https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html (accessed 2026-11-14) ↩︎
Vaswani et al., "Attention Is All You Need" (2017), 3.2.1절. https://arxiv.org/abs/1706.03762 (accessed 2026-11-14) ↩︎
NVIDIA, "Matrix Multiplication Background User's Guide," 2.1절. https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html (accessed 2026-11-14). 덧셈 구간까지 여러 묶음에 나눠 맡기는 방법(split-K)도 있어서 "기본적으로"라고 썼습니다. NVIDIA CUTLASS, "Efficient GEMM in CUDA," Parallelized Reductions 절. https://github.com/NVIDIA/cutlass/blob/main/media/docs/cpp/efficient_gemm.md#parallelized-reductions (accessed 2026-11-14) ↩︎
openai/gpt-2, "download_model.py." https://github.com/openai/gpt-2/blob/master/download_model.py (accessed 2026-11-14). 파일 크기는 https://openaipublic.blob.core.windows.net/gpt-2/models/1558M/model.ckpt.data-00000-of-00001 의 응답 헤더(Content-Length)로 확인했습니다. ↩︎
GitHub Docs, "About large files on GitHub." https://docs.github.com/en/repositories/working-with-files/managing-large-files/about-large-files-on-github (accessed 2026-11-14) ↩︎